هوش مصنوعی در حال تغییر بسیاری از جنبههای زندگی ماست؛ از نحوه رانندگی گرفته تا شیوه برقراری ارتباط با دیگران. اکنون، این فناوری وارد نسل جدیدی از پردازش صدا در سمعکها نیز شده است.
در موقعیتهای روزمره مانند رستورانهای شلوغ، دورهمیهای خانوادگی یا تماشای یک مسابقه از کنار زمین، صداها بهصورت جداگانه به گوش نمیرسند. گفتار، صدای پسزمینه و سایر منابع صوتی با یکدیگر همپوشانی دارند، تغییر میکنند و برای جلب توجه شنونده با یکدیگر رقابت میکنند.
در چنین محیطهایی، تنها تقویت صدا کافی نیست و نحوه پردازش سیگنالهای صوتی نقش مهمی در دسترسی بهتر به گفتار دارد. اینجاست که فناوریهای پیشرفته مبتنی بر هوش مصنوعی میتوانند نقش متفاوتی ایفا کنند.
هوش مصنوعی چگونه در سمعکها استفاده میشود؟
بسیاری از سمعکهای مدرن از الگوریتمهای پیشرفته برای شناسایی گفتار و طبقهبندی محیطهای شنیداری مختلف، مانند محیط آرام، گفتار در حضور نویز یا موسیقی استفاده میکنند.
بر اساس این اطلاعات، سمعک میتواند تنظیماتی مانند جهتداری (Directionality) یا کاهش نویز (Noise Reduction) را متناسب با محیط تغییر دهد.
کاربردهای پیشرفتهتر هوش مصنوعی یک گام فراتر میروند و مستقیماً در پردازش سیگنال صوتی نقش ایفا میکنند.
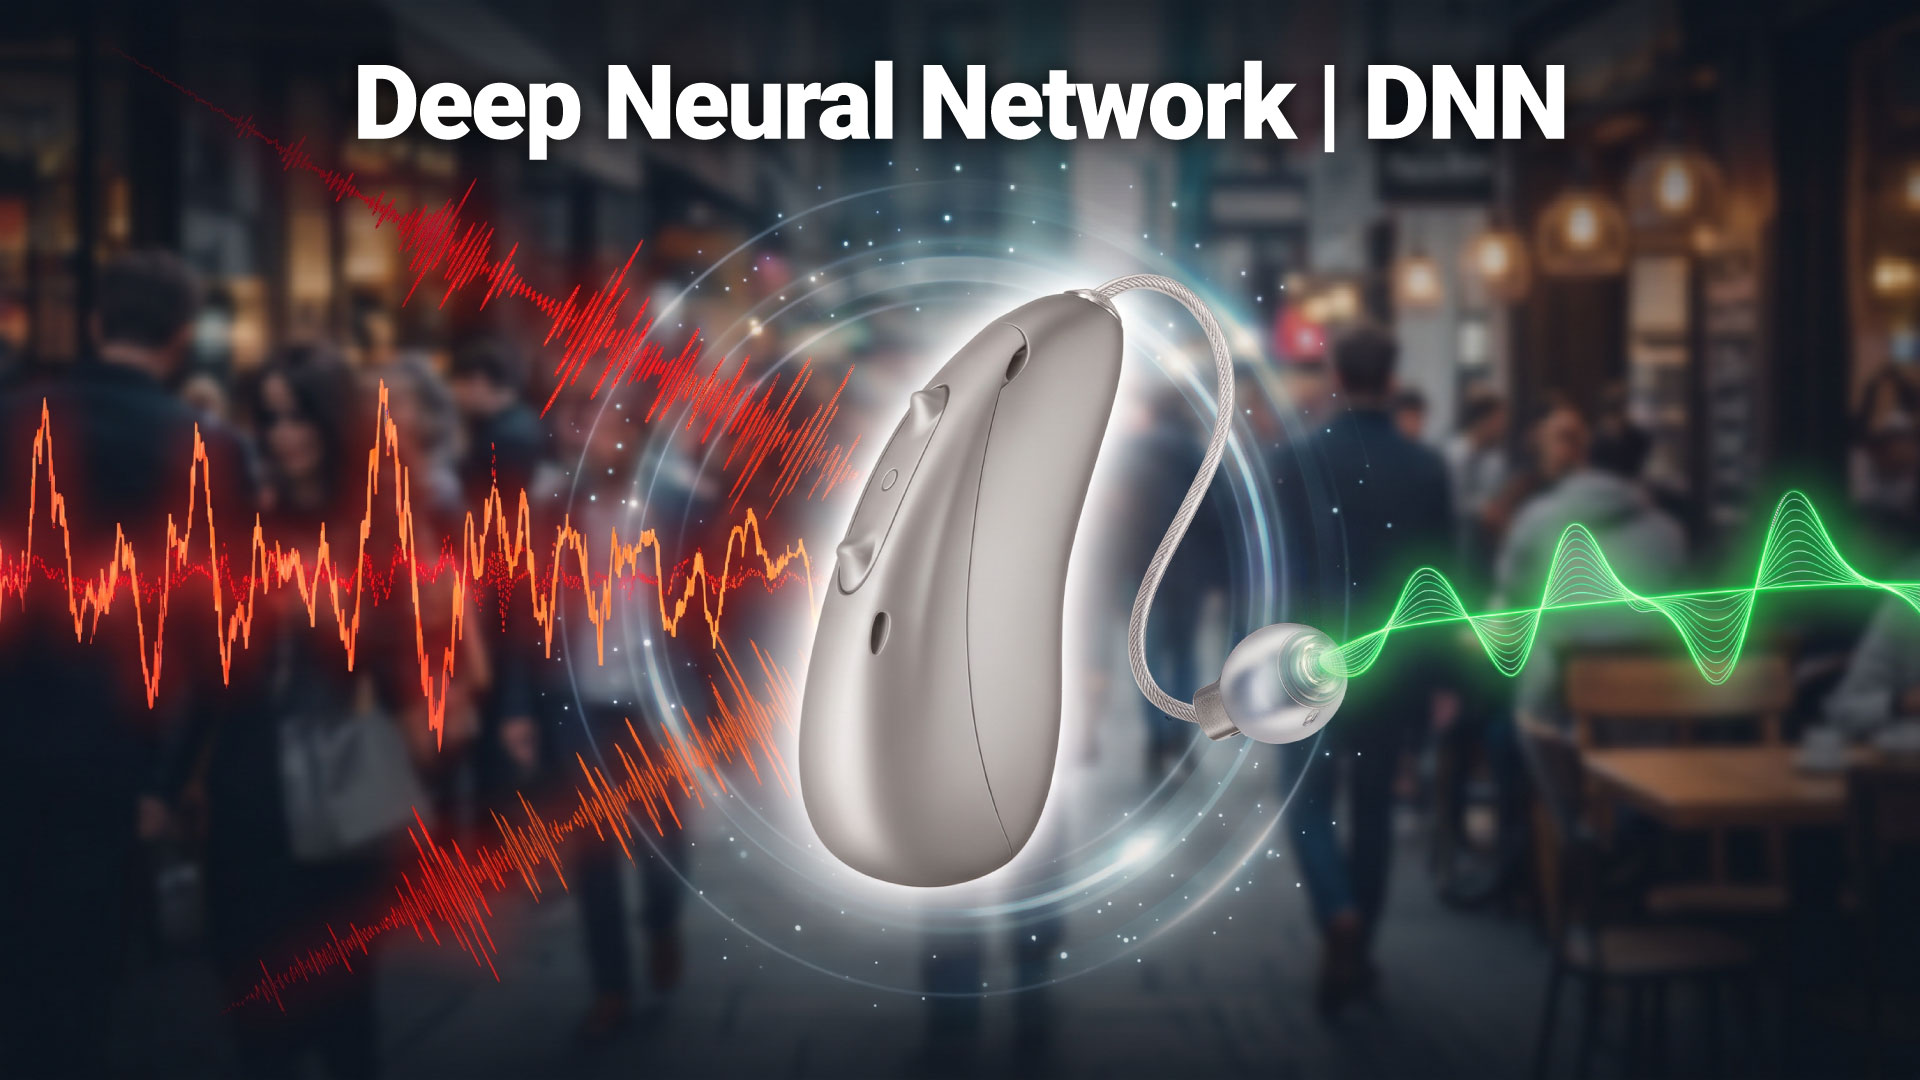
یکی از این فناوریها، شبکه عصبی عمیق (Deep Neural Network | DNN) است که Sonova در نسل جدید فناوریهای شنوایی خود از آن استفاده کرده است.
شبکه عصبی عمیق یا DNN چیست؟
شبکه عصبی عمیق نوعی فناوری مبتنی بر هوش مصنوعی است که میتواند با استفاده از حجم گستردهای از دادهها آموزش ببیند.
DNN مورد استفاده Sonova با دادههای صوتی گسترده شامل گفتار در محیطهای آرام و پرنویز آموزش داده شده است. این فرایند به سیستم کمک میکند الگوهای مرتبط با گفتار را در محیط صوتی تشخیص دهد و با صداهای رقیب، حتی زمانی که از جهتهای مختلف میآیند، بهتر مواجه شود.
در یک محیط شنیداری پیچیده و پرنویز، این فناوری میتواند:
- گفتار را در محیطهای صوتی پیچیده شناسایی کند؛
- گفتار را از نویزهای رقیب جدا کند؛
- با تغییر تعداد گویندگان یا جهت صداها، به حفظ وضوح گفتار کمک کند.
این پردازش در زمان واقعی انجام میشود و به سمعک امکان میدهد متناسب با تغییر شرایط محیط شنیداری واکنش نشان دهد.
تفاوت DNN با روشهای متداول پردازش صدا چیست؟
یکی از روشهایی که در سمعکها برای بهبود دسترسی به گفتار در محیطهای پرنویز استفاده شده، Beamforming دوگوشی (Binaural Beamforming) است.
در این روش، سیستم میتواند بر گفتاری که از جهت مشخصی میآید تمرکز کند و تأثیر برخی صداهای رقیب را کاهش دهد.
در فناوری DNN مورد استفاده Sonova، پردازش به تشخیص گفتار از یک جهت مشخص محدود نمیشود. سیستم برای شناسایی گفتار در محیط صوتی، جداسازی آن از نویزهای رقیب و مدیریت شرایطی طراحی شده است که صداها و گویندگان از جهتهای مختلف حضور دارند.
وقتی چند نفر همزمان صحبت میکنند چه اتفاقی میافتد؟
یک مسابقه فوتبال را تصور کنید.
از کنار زمین صدای تشویق تماشاگران شنیده میشود، صدای سوت در محیط وجود دارد و افراد مختلف در اطراف شما در حال صحبت هستند. بعضی صداها از روبهرو، برخی از کنار و برخی از پشت سر شنیده میشوند و این شرایط نیز دائماً در حال تغییر است.
دنبالکردن یک مکالمه در چنین محیطی میتواند دشوار باشد.
فناوری DNN برای مدیریت چنین موقعیتهایی طراحی شده است؛ یعنی شرایطی که چندین گوینده و چندین منبع نویز بهطور همزمان در محیط حضور دارند. سیستم با پردازش سیگنال در زمان واقعی تلاش میکند گفتار را از نویزهای رقیب جدا کند و دسترسی به مکالمه را آسانتر سازد.
Moxi™ S-RX؛ استفاده از DNN در سمعکهای یونیترون
Moxi™ S-RX از Unitron یکی از سمعکهایی است که از فناوری پردازش مبتنی بر DNN استفاده میکند.
این سمعک شارژی برای مدیریت محیطهای شنیداری پویا طراحی شده و در آن فناوری SoundSonic360™ با استفاده از پردازش مبتنی بر هوش مصنوعی، گفتار را از نویز پسزمینه جدا میکند.
SoundSonic360 برای:
- تشخیص الگوهای گفتار در محیط؛
- شناسایی صداهای گفتاری در میان نویزهای رقیب؛
- حفظ دسترسی به مکالمه همزمان با کاهش صداهای مزاحم؛
- و تشخیص مداوم گفتار با ورود آن به محیط شنیداری
طراحی شده است.
در سطح سختافزاری، این فناوری از تراشه اختصاصی DEEPSONIC™ DNN استفاده میکند و Integra OS نیز پردازش و واکنش سیستم به شرایط محیط را در زمان واقعی هدایت میکند.
قابلیتهای Moxi S-RX
بر اساس اطلاعات رسمی Unitron، برخی از قابلیتهای اصلی Moxi S-RX عبارتاند از:
- SoundSonic360™: جداسازی گفتار از نویز با استفاده از پردازش مبتنی بر هوش مصنوعی
- تراشه اختصاصی DEEPSONIC™ DNN
- طبقهبندی خودکار محیط و سازگاری صدا با استفاده از Integra OS
- برنامههای اختیاری مبتنی بر هوش مصنوعی در اپلیکیشن، شامل SpeechSonic و NoiseSonic
- قابلیت AI Noise Filter برای تنظیم شدت پردازش بر اساس ترجیح کاربر
- اتصال بلوتوث® یونیورسال برای تماس و پخش محتوای صوتی
- سازگاری با اپلیکیشن Remote Plus برای شخصیسازی برخی تنظیمات و ارائه بازخورد
- طراحی RIC شارژی
پرسشهای متداول درباره هوش مصنوعی در سمعکها
فناوری DNN در سمعکهای Unitron چگونه کار میکند؟
DNN مخفف Deep Neural Network یا شبکه عصبی عمیق است. این فناوری با حجم گستردهای از دادههای صوتی آموزش داده شده است تا بتواند الگوهای گفتار را شناسایی و آن را از نویزهای رقیب تفکیک کند؛ حتی در محیطهایی که گفتار از جهتهای مختلف یا از سوی چند گوینده شنیده میشود.
آیا همه سمعکها از هوش مصنوعی استفاده میکنند؟
خیر. همه سمعکها از هوش مصنوعی استفاده نمیکنند و در محصولاتی که از این فناوری بهره میبرند نیز نحوه استفاده از آن یکسان نیست.
در برخی سیستمها، هوش مصنوعی بیشتر برای طبقهبندی محیط شنیداری به کار میرود؛ درحالیکه در فناوری DNN مورد استفاده Sonova، شبکه عصبی در پردازش سیگنال خروجی نیز نقش دارد. Unitron این رویکرد را یکی از تفاوتهای فناوری جدید خود معرفی میکند.
آیا DNN تمام نویزهای پسزمینه را حذف میکند؟
خیر. هدف این فناوری حذف کامل تمام صداهای محیط نیست.
DNN برای جداسازی بهتر گفتار از نویزهای رقیب و مدیریت صدای پسزمینه طراحی شده است، درحالیکه حفظ آگاهی کاربر از محیط اطراف نیز مورد توجه قرار میگیرد.
آیا DNN میتواند در مکالمات چندنفره کمککننده باشد؟
بله. فناوری DNN مورد استفاده در Moxi S-RX برای محیطهایی طراحی شده است که چند نفر صحبت میکنند و صداهای گفتاری و نویزهای محیطی از جهتهای مختلف به گوش میرسند.
SoundSonic360 میتواند گفتار را از جهات مختلف شناسایی و در حضور نویزهای رقیب پردازش کند.
جمعبندی
ورود شبکههای عصبی عمیق به فناوری سمعک، رویکرد جدیدی را در پردازش محیطهای شنیداری پیچیده ایجاد کرده است. در این رویکرد، هوش مصنوعی تنها برای تشخیص نوع محیط استفاده نمیشود، بلکه میتواند مستقیماً در پردازش سیگنال و جداسازی گفتار از نویز نقش داشته باشد.
در Moxi S-RX یونیترون، ترکیب SoundSonic360، تراشه DEEPSONIC DNN و Integra OS برای پردازش گفتار در محیطهای پرنویز و پویا به کار گرفته شده است؛ محیطهایی که ممکن است چندین گوینده و منبع صوتی از جهتهای مختلف در آن حضور داشته باشند.
این فناوری نمونهای از مسیری است که هوش مصنوعی در حال ایجاد آن در حوزه شنوایی است: حرکت از صرفاً تقویت صدا به سمت پردازش هوشمندتر محیطهای شنیداری پیچیده.
منبع
Unitron – AI is changing how we hear: What is DNN technology in hearing aids?