در سالهای اخیر، هوش مصنوعی به یکی از مهمترین محورهای توسعه فناوری سمعک تبدیل شده است؛ اما استفاده از عبارت «هوش مصنوعی» بهتنهایی نمیتواند نشان دهد که یک سمعک واقعاً چه تفاوتی در تجربه شنیداری ایجاد میکند.
مسئله اصلی برای بسیاری از کاربران، شنیدن در محیط آرام نیست. چالش واقعی زمانی آغاز میشود که فرد در یک رستوران شلوغ، دورهمی خانوادگی، جلسه کاری یا محیطی با چندین منبع صوتی همزمان قرار میگیرد؛ جایی که صدای گفتار با نویز و صداهای مزاحم ترکیب میشود.
در چنین شرایطی، هدف فناوریهای جدید دیگر صرفاً «تقویت صدا» نیست؛ بلکه سمعک باید بتواند تشخیص دهد کدام بخش از محیط صوتی برای کاربر اهمیت بیشتری دارد و در لحظه، پردازش مناسبی برای افزایش دسترسی به گفتار انجام دهد.
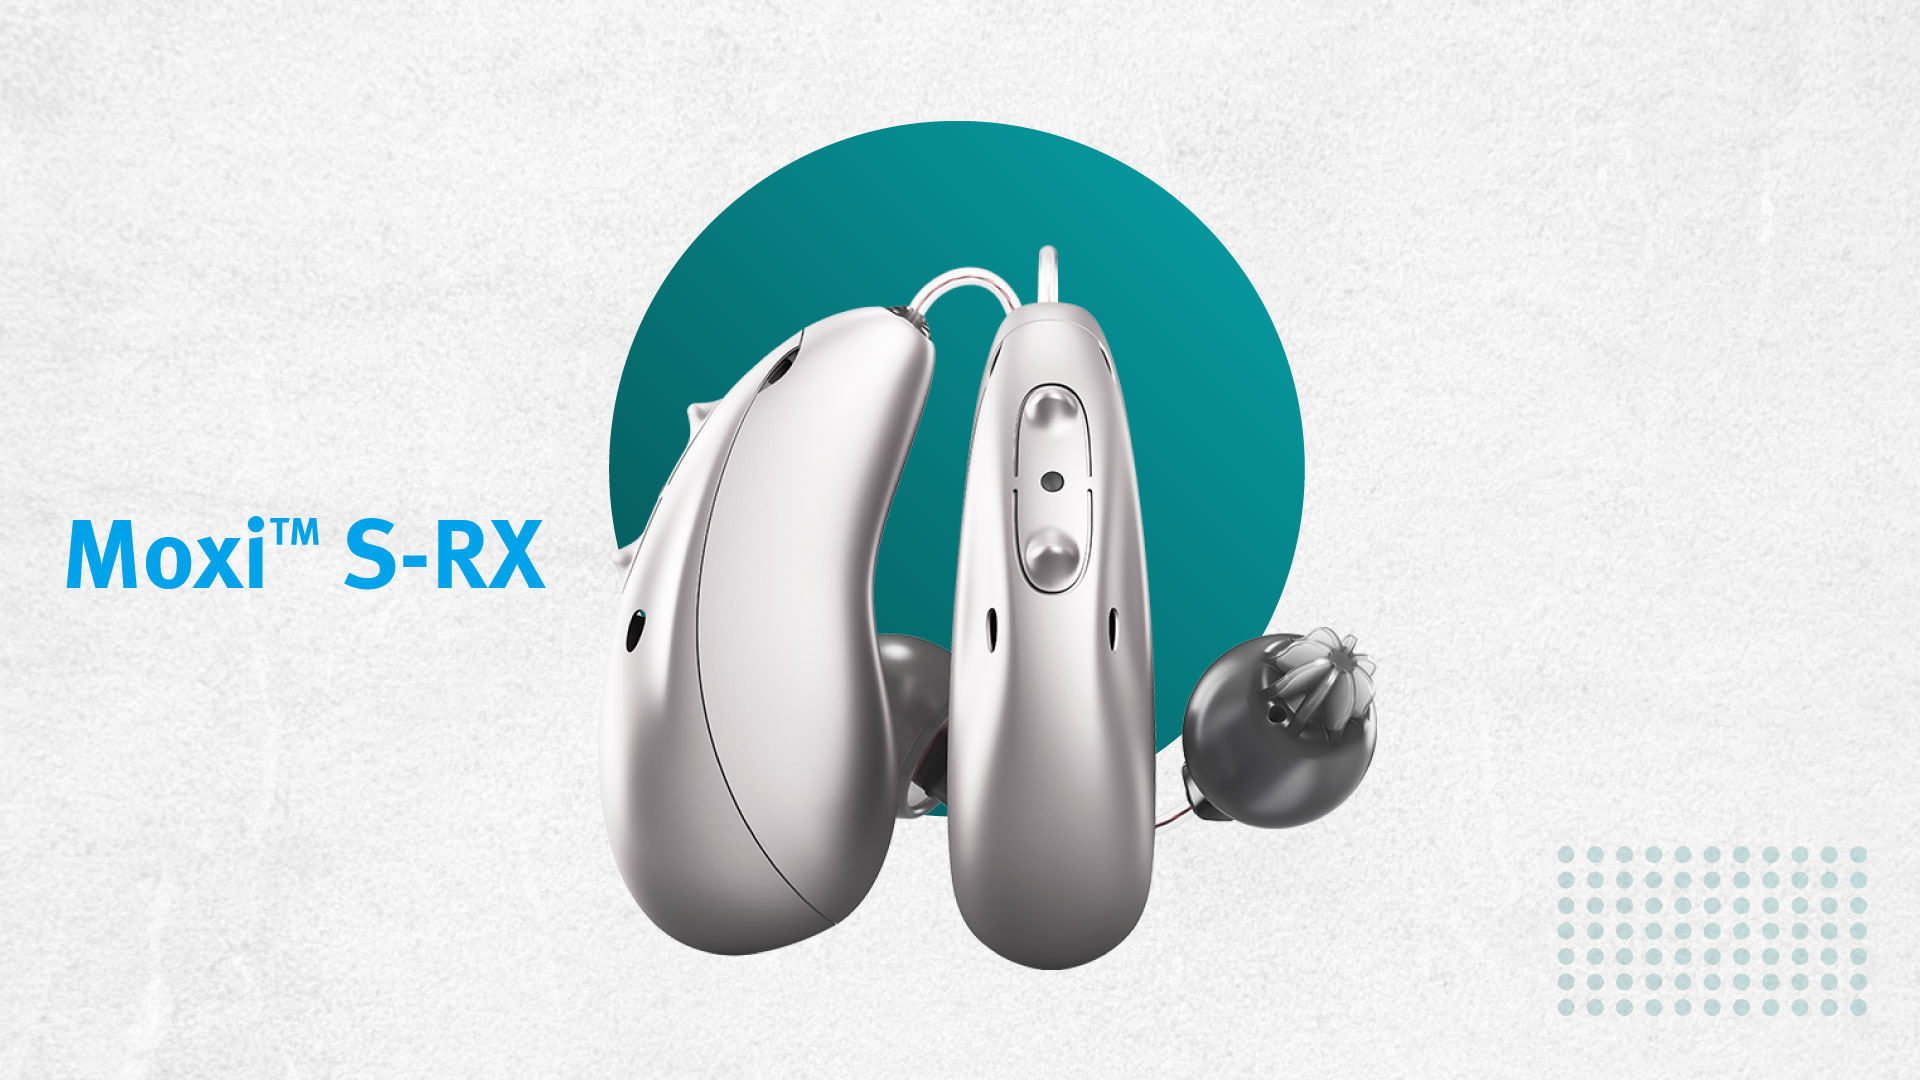
سمعک Unitron Moxi S-RX با ترکیب یک معماری پردازشی دو تراشهای، هوش مصنوعی مبتنی بر Deep Neural Network (DNN) و فناوری SoundSonic360، رویکرد متفاوتی را برای مدیریت گفتار در نویز ارائه میکند.
چیزی که این محصول را متمایز میکند، صرفاً اضافه شدن یک قابلیت هوش مصنوعی نیست؛ بلکه نحوه همکاری بخشهای مختلف سیستم برای پردازش همزمان محیط و گفتار است.
آیا هوش مصنوعی در سمعکهای یونیترون فناوری جدیدی است؟
یکی از نکات مهم مطرحشده این است که استفاده از هوش مصنوعی و یادگیری ماشین در محصولات شنوایی یونیترون موضوعی کاملاً جدید نیست.
این شرکت بیش از دو دهه است که از رویکردهای مبتنی بر هوش مصنوعی و یادگیری ماشین در سیستمهای پردازشی خود استفاده میکند.
یکی از نمونههای مهم این رویکرد، Integra OS است؛ سیستمی که محیط صوتی اطراف کاربر را بهصورت مداوم تحلیل کرده و بر اساس شرایط محیطی، تنظیمات و قابلیتهای سمعک را بهصورت خودکار تغییر میدهد.
بنابراین تفاوت نسل جدید Moxi S-RX را نباید صرفاً در استفاده از AI جستوجو کرد. نقطه تمایز اصلی، ورود یک Deep Neural Network اختصاصی برای جداسازی گفتار از نویز به معماری پردازشی دستگاه است.
DEEPSONIC؛ تراشه اختصاصی برای پردازش گفتار در نویز
یکی از مهمترین اجزای معماری Moxi S-RX، تراشه DEEPSONIC است.
این تراشه برای اجرای پردازش مبتنی بر شبکه عصبی عمیق یا Deep Neural Network (DNN) طراحی شده و نقش اصلی آن در سیستم، جداسازی گفتار از نویز و بهبود سیگنال گفتاری در زمان واقعی است.
در معماری Moxi S-RX، DEEPSONIC در کنار تراشه ERA قرار گرفته است. هر کدام از این دو تراشه وظیفه متفاوتی دارند و در کنار یکدیگر یک سیستم پردازشی دو تراشهای را تشکیل میدهند.
تراشه ERA چه نقشی دارد؟
تراشه ERA را میتوان بخش مهمی از سیستم مدیریت محیطی Moxi S-RX دانست.
در این معماری، ERA همراه باIntegra OS وظیفه طبقهبندی محیط صوتی و اعمال تنظیمات خودکار مناسب را بر عهده دارد.
برای مثال، سمعک باید بتواند میان شرایط شنیداری مختلف تفاوت ایجاد کند و متناسب با محیط، نحوه پردازش سیگنال را تغییر دهد.
بنابراین ERA بیشتر بر شناخت و مدیریت محیط صوتی تمرکز دارد؛ درحالیکه DEEPSONIC بهطور اختصاصی برای پردازش گفتار و نویز به کار گرفته میشود.
این معماری دوگانه یکی از نکات کلیدی Moxi S-RX محسوب میشود.
SoundSonic360 چیست؟
یکی از مهمترین قابلیتهای معرفیشده برای Moxi S-RX، فناوری SoundSonic360 است.
SoundSonic360 یک قابلیت کاهش نویز مبتنی بر Deep Neural Network است که از توان پردازشی DEEPSONIC استفاده میکند.
نکته مهم این فناوری، تمرکز آن بر جداسازی گفتار از نویز در زمان واقعی است.
در سیستمهای سنتیتر، بسیاری از فناوریهای جهتدار تلاش میکنند تمرکز اصلی را روی صدایی قرار دهند که از سمت جلوی فرد وارد میشود.
SoundSonic360 رویکرد متفاوتی دارد و میتواند گفتار را از جهات مختلف محیطی پردازش کند.
این ویژگی در موقعیتهای واقعی اهمیت زیادی دارد؛ زیرا فرد همیشه روبهروی شخصی که با او صحبت میکند قرار ندارد.
ممکن است فردی از کنار، پشت سر یا زاویهای خارج از محدوده مستقیم دید کاربر صحبت کند.
در چنین شرایطی، توانایی پردازش گفتار از جهتهای مختلف میتواند اهمیت بالینی و کاربردی قابلتوجهی داشته باشد.
تفاوت SoundSonic360 با فناوریهای جهتدار قدیمیتر
یکی از مقایسههای مطرحشده در مصاحبه، مقایسه SoundSonic360 با فناوریهایی مانند HyperFocus است.
فناوریهای Beamforming یا شکلدهی پرتو معمولاً با استفاده از آرایه میکروفونها تلاش میکنند تمرکز بیشتری روی سیگنال صوتی از یک جهت مشخص ایجاد کنند.
این رویکرد در بسیاری از موقعیتهای شنیداری مؤثر است؛ اما یک محدودیت طبیعی دارد:
اگر فردی که با کاربر صحبت میکند در جهت مورد انتظار قرار نداشته باشد، سیستم جهتدار ممکن است با چالش بیشتری مواجه شود.
SoundSonic360 با تکیه بر شبکه عصبی عمیق، تلاش میکند این محدودیت را کاهش دهد و پردازش گفتار را مستقلتر از جهت منبع صوتی انجام دهد.
به همین دلیل، هدف این فناوری تنها «کاهش صدای محیط» نیست؛ بلکه ایجاد شرایطی است که کاربر بتواند گفتار موردنظر را با تلاش شنیداری کمتری دنبال کند.
نتایج گزارششده برای SoundSonic360
بر اساس دادههایی که از سوی یونیترون ارائه شده، SoundSonic360 در مقایسه با فناوریهای نسل قبلی میتواند مزایای قابلتوجهی در شرایط شنیداری دشوار ایجاد کند.
طبق این دادهها:
- بهبود نسبت سیگنال به نویز تا ۱۰ دسیبل
- افزایش سهبرابری احتمال درک گفتار از جهات مختلف
- کاهش تا ۳۷ درصدی تلاش شنیداری
برای کاربران، اهمیت این اعداد در نهایت به یک موضوع اساسی برمیگردد: کاهش فشار ذهنی و شنیداری هنگام دنبال کردن مکالمه در محیطهای شلوغ.
چرا کاهش «تلاش شنیداری» اهمیت دارد؟
یکی از مفاهیم مهم در ارزیابی فناوریهای جدید سمعک، مفهوم Listening Effort یا تلاش شنیداری است.
فردی که دچار کمشنوایی است، ممکن است حتی زمانی که از نظر ظاهری «صدا را میشنود»، برای درک گفتار در محیط شلوغ انرژی شناختی زیادی صرف کند.
بهعنوان مثال، در یک رستوران شلوغ، فرد ممکن است مجبور شود:
- دائماً روی لبهای گوینده تمرکز کند؛
- از گوینده بخواهد جمله را تکرار کند؛
- حدس بزند چه کلماتی گفته شدهاند؛
- از سایر اعضای مکالمه عقب بماند؛
- یا پس از مدت کوتاهی احساس خستگی شنیداری کند.
بنابراین موفقیت یک سمعک تنها با این معیار سنجیده نمیشود که آیا صدای گفتار قابل شنیدن است یا خیر.
یک سؤال مهمتر این است:
کاربر برای فهمیدن آن گفتار چقدر باید تلاش کند؟
فناوریهایی مانند SoundSonic360 با هدف قرار دادن همین مسئله تلاش میکنند تجربه شنیداری را از یک فرآیند پرزحمت به تجربهای طبیعیتر و کمتنشتر تبدیل کنند.
Moxi S-RX برای چه کاربرانی اهمیت بیشتری دارد؟
Moxi S-RX بیش از آنکه صرفاً برای شنیدن در محیط آرام طراحی شده باشد، توجه ویژهای به شرایط پیچیده شنیداری دارد.
بنابراین فناوریهای آن میتوانند برای افرادی که در موقعیتهایی مانند موارد زیر قرار میگیرند، اهمیت بیشتری داشته باشند:
- رستورانها و کافههای شلوغ
- جلسات کاری
- دورهمیهای خانوادگی
- مهمانیها
- محیطهای اجتماعی پرجمعیت
- مکالمه با چند نفر
- موقعیتهایی که گوینده همیشه روبهروی کاربر قرار ندارد
با این حال، انتخاب سمعک باید همچنان بر اساس ارزیابی کامل شنوایی، نیازهای ارتباطی، سبک زندگی، میزان کمشنوایی و نظر شنواییشناس انجام شود.
هیچ فناوری واحدی نمیتواند برای تمام کاربران و تمام محیطها بهترین انتخاب باشد.
جمعبندی
نسل جدید سمعکها در حال عبور از مفهوم سنتی «تقویت صدا» هستند.
در یک سمعک مدرن، سیستم باید بتواند محیط را تحلیل کند، شرایط شنیداری را تشخیص دهد، سیگنالهای مهم را شناسایی کند و بر اساس شرایط، پردازش مناسب را بهصورت خودکار اعمال کند.
Unitron Moxi S-RX با استفاده از معماری دو تراشهای شامل ERA و DEEPSONIC و ترکیب آن با Integra OS، Deep Neural Network و SoundSonic360 رویکردی را دنبال میکند که تمرکز آن بر بهبود درک گفتار در محیطهای پیچیده و کاهش تلاش شنیداری است.
SoundSonic360 میتواند نسبت سیگنال به نویز را تا ۱۰ دسیبل بهبود دهد، احتمال درک گفتار از جهات مختلف را سه برابر کند و تلاش شنیداری را تا ۳۷ درصد کاهش دهد.
برای شنواییشناسان، این تغییر رویکرد اهمیت ویژهای دارد؛ زیرا آینده سمعکها تنها به افزایش قدرت پردازش وابسته نیست، بلکه به این موضوع بستگی دارد که این قدرت پردازشی چگونه میتواند در موقعیتهای واقعی زندگی، دسترسی فرد به گفتار را افزایش دهد و هزینه شنیداری مکالمه را کاهش دهد.